Tijdsdynamiek
Het RuimteScanner 2.0 model werkt niet met een enkele tijdstap, maar simuleert ruimtelijke ontwikkelingen over een reeks zichtjaren. Deze pagina beschrijft hoe de temporele structuur is opgebouwd, welke keuzen daarin zijn gemaakt en welke afhankelijkheden tussen parameters bestaan.
Basisjaar en eindjaar
Het model kent drie ankerjaren, met tussen haakjes de waarde in de NL2120-toepassing:
Model_StartYear(2023): het basisjaar van waaruit de simulatie start. De stand in dit jaar (woningen, banen, pandfootprints, landgebruik) vormt de uitgangssituatie.Model_FirstZichtjaar(2040): het eerste zichtjaar, en daarmee het tweede modeljaar na het basisjaar.Model_FinalYear(2120): het laatste jaar waarvoor de allocatie wordt doorgerekend.
Het basisjaar heeft een dubbele functie. Het is zowel het startpunt van de allocatie als het ijkjaar voor dichtheden: de verhouding woningen per hectare en banen per m² pandfootprint in dit jaar vormt de referentie voor alle dichtheidsberekeningen in latere zichtjaren.
Relatie met inputdata
Het basisjaar moet overeenkomen met het peiljaar van de belangrijkste inputregistraties. De meest kritische koppeling is die met LISA (Landelijk Informatiesysteem Arbeidsplaatsen), vanwege de centrale rol van banendata in de dichtheidsberekening voor werken. Wanneer werken wordt meegealloceerd geldt daarom de eis dat Model_StartYear gelijk is aan LISA_StartYear. Deze eis wordt afgedwongen via een IntegrityCheck.
De achtergrond is dat de werkdichtheid (m² pandfootprint per hectare) wordt berekend als een breuk waarvan de teller (pandfootprint per subsector) uit het LISA-jaar wordt opgehaald en de noemer (hectare per landgebruiksklasse) uit het Model_StartYear. Bij ongelijke jaren is deze ratio inconsistent. Daarnaast worden banen uit LISA gekoppeld aan panden uit de BAG van het overeenkomstige jaar; bij een mismatch bevatten panden die na het LISA-peiljaar zijn gebouwd geen banen, wat de dichtheidsratio lokaal verstoort.
Andere inputregistraties (BAG, BBG, BGT, NVM) hebben hun eigen peiljaren die via parameters in ModelParameters.dms worden ingesteld. De BAG wordt ook gebruikt voor een recenter peiljaar dan het basisjaar (via BAG_RecentYear), om recente bouwontwikkelingen mee te nemen. Zie BAG nieuwbouw in details voor deze procedure.
Zichtjaren
Tussen het basisjaar en het eindjaar liggen de zichtjaren: de tijdstippen waarvoor het model een allocatie doorrekent. De set wordt opgebouwd in Classifications/Time.dms:
- Het basisjaar zelf (
Model_StartYear). Dit is geen zichtjaar in de allocatie maar het startpunt. - Het eerste zichtjaar (
Model_FirstZichtjaar). - Vanaf daar een zichtjaar per
Model_ZichtjaarIntervaljaar, tot en met het eindjaar (Model_FinalYear). Een IntegrityCheck eist dat het eindjaar precies op dat raster valt, anders zou het wegvallen.
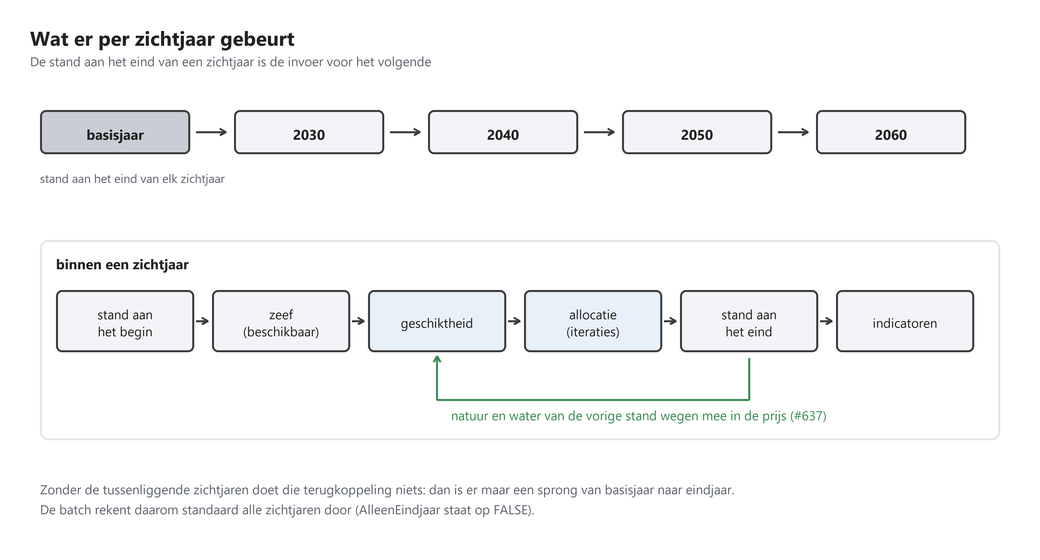
In de NL2120-toepassing, met een interval van tien jaar, zijn dat negen zichtjaren, Y2040 tot en met Y2120. Elk zichtjaar kent een voorganger (PrevYear); voor het eerste is dat het basisjaar. De allocatie voor een zichtjaar bouwt voort op de resultaten van zijn voorganger.
Het eerste zichtjaar is instelbaar; in de NL2120-toepassing staat het op 2040 (#658). De TIGRIS-claim voor 2030 ligt in veel regio’s onder de stand van het basisjaar, bij de banen zelfs in vrijwel alle regio’s. Het model kan geen woningen of banen slopen om een claim te halen, dus daar kon alleen overrealisatie uitkomen; zie Claimrealisatie. Met 2040 als eerste zichtjaar vervalt die klem voor het merendeel van de regio’s. De eerste allocatiestap beslaat dan zeventien jaar in plaats van zeven. De groeifactoren rekenen met de werkelijke periodelengte uit Zichtjaar/PrevYearRange_rel, dus dat gaat vanzelf goed, maar het tussenstation 2030 ontbreekt wel in de padafhankelijkheid.
De claims lopen niet zo ver door als de zichtjaren. TIGRIS levert tot en met 2060, en ModelParameters/Advanced/FromWhichDoWeKeepTIGRISconstant (2060) zorgt ervoor dat elk zichtjaar daarna de claimmap van 2060 leest. Vanaf 2070 groeit de opgave voor wonen en werken dus niet meer, en verschillen tussen varianten in die jaren komen uit de ruimtelijke sturing en niet uit extra vraag.
AlleenEindjaar
De parameter AlleenEindjaar (standaard: FALSE) bepaalt of alle zichtjaren worden doorlopen of alleen het eindjaar.
Bij TRUE springt het model direct van het basisjaar naar het eindjaar. De tussenliggende zichtjaren worden niet berekend en verschijnen niet in de GeoDMS-boom. Dit bespaart rekentijd, maar de padafhankelijkheid vervalt: verdichtings- en verdringingsmechanismen die normaal doorheen decennia doorwerken worden overgeslagen.
Bij FALSE worden alle zichtjaren sequentieel doorlopen. De resultaten van elk zichtjaar (de stand na allocatie) vormen de input voor het volgende. Dit is de volledig padafhankelijke modus.
De keuze heeft effect op de modelresultaten. Bij AlleenEindjaar=TRUE worden alle claims voor de gehele periode in een keer gealloceerd, waardoor het model meer ruimte in een keer opvult zonder tussentijdse terugkoppeling. In batchmodus wordt deze parameter aangestuurd via de omgevingsvariabele AlleenEindjaar; RunAll.cmd zet hem standaard op FALSE en vraagt of je toch alleen het eindjaar wilt, Run2120.ps1 zet hem niet en toont bij de start de stand uit de configuratie.
Sequentieel doorrekenen is niet alleen een kwestie van nauwkeurigheid (#637). De geschiktheid voor wonen weegt de natuur en het water mee die aan het begin van een zichtjaar liggen, en dat mechanisme doet niets wanneer er maar een zichtjaar is. Zie Geschiktheid.
Sequences en iteraties
Binnen elk zichtjaar doorloopt het model twee geneste lussen: sequences (buitenste lus) en iteraties (binnenste lus).
Iteraties
Iteraties zijn nodig om concurrentie tussen subsectoren te simuleren. In elke iteratie wordt een deel van de regionale claim voor elke subsector toegewezen aan de meest geschikte beschikbare locaties. Na elke iteratie blijven er restlocaties (waar nog niet is gealloceerd) en restclaims (regionale vraag die nog niet is vervuld) over. In de volgende iteratie worden de restclaims toegewezen aan de restlocaties.
Het aantal iteraties wordt ingesteld via Default_NrOfIters in ModelParameters.dms, en dat staat op 15. Een hoger aantal iteraties leidt tot een fijnmaziger verdeling maar een langere rekentijd. De allocatietabel kan er per regel van afwijken: wonen en werken op NVM-niveau draaien in latere sequences op 5 iteraties in plaats van op de default.
Sequences
Sequences zijn nodig om verdringing tussen sectoren op te vangen. Wanneer een sector locaties claimt waar al actoren of objecten uit een eerdere sector aanwezig waren, worden die bestaande actoren/objecten verdrongen. De verdrongen eenheden genereren restclaims die in een volgende sequence opnieuw worden gealloceerd.
Het minimale aantal sequences is 2 (Default_NrOfSequences, afgedwongen via IntegrityCheck). In de eerste sequence worden alle sectoren in volgorde gealloceerd. In de tweede sequence worden alleen de sectoren opnieuw doorlopen die in de eerste sequence verdringing hebben ondervonden (aangestuurd via UseInLaterSequences per sector-allocatieregio-combinatie).
Sectorvolgorde
De volgorde waarin sectoren worden gealloceerd is vastgelegd in de tabel SectorAllocRegio in ModelParameters.dms, niet bij de variantparameters. Elke regel noemt een sector, het regionale schaalniveau, of de sector in latere sequences opnieuw wordt doorlopen, en het aantal iteraties in de eerste en in de latere sequences. Sectoren die niet meedraaien staan als uitgecommentarieerde regel in dezelfde tabel, zodat aanzetten een kwestie is van de regel terugzetten en het rijtotaal ophogen. In de toepassing NL2120 zijn acht regels actief:
- Wonen op NVM-niveau, daarna COROP, daarna Provincie
- Werken op NVM-niveau, daarna COROP, daarna Provincie
- Waterberging op het niveau van de waterbergingsregio
- Landbouw op provincieniveau
Verblijfsrecreatie, zon en wind staan daar uitgecommentarieerd. Dat is een keuze van die toepassing en geen eigenschap van het model.
Per sector wordt de allocatie op meerdere regionale schaalniveaus uitgevoerd, van fijn naar grof. Elk grover niveau zet de claim van zijn eigen regio opnieuw tegen de stand, zodat een tekort in een fijne regio op het grovere niveau ruimte vindt zolang de grotere regio als geheel nog een restclaim heeft; zie Overflow. De parameter UseInLaterSequences bepaalt per sector-regiocombinatie of de sector in latere sequences opnieuw wordt doorlopen bij verdringing.
Ontkoppeling
Het model kan in stappen worden uitgevoerd door tussenresultaten op te slaan (“ontkoppelen”) en bij vervolgberekeningen te hergebruiken. Dat bepaalt de rekentijd tijdens ontwikkeling en debugging, en het maakt een batchrun met een proces per zichtjaar mogelijk.
De keten van de allocatie kent drie stappen, elk met een eigen schakelaar:
| Parameter | Stap | Wat wordt ontkoppeld |
|---|---|---|
BaseDataOntkoppeld | 1 | Generieke, scenario- en variantonafhankelijke data |
VariantDataOntkoppeld | 2 | Variantspecifieke data van voor de allocatie |
StandAllocatieOntkoppeld | 3 | De stand na de allocatie per zichtjaar; een zichtjaar leest dan de stand van zijn voorganger uit de tifs |
De indicatoren hebben er twee: IndicatorenOntkoppeld, waarmee een zichtjaar wat het van zijn voorganger nodig heeft uit de ketentifs leest, en TabellenUitExport, waarmee de tabellen de geschreven kaarten teruglezen. De schakelaars voor losse bestanden, zoals BAG_WP5_rel_Ontkoppeld en OpbrengstdervingOntkoppeld, en het mechanisme dat bepaalt of een bestand hergebruikt mag worden, staan op Ontkoppelde bestanden.
Een parameter op TRUE zetten betekent: lees dit onderdeel van schijf in plaats van het opnieuw te berekenen. Voorwaarde is dat de ontkoppelde bestanden actueel zijn voor de huidige configuratie. In een productierun schrijven eigen stappen eerst de basisdata en de variantdata weg, en rekent de allocatie daarna met alle drie de schakelaars op TRUE; zie Batchrun draaien.
Niet alle combinaties zijn zinvol. VariantDataOntkoppeld=FALSE samen met BaseDataOntkoppeld=FALSE heeft alleen zin als ook de basisdata echt opnieuw moet worden gemaakt. Een IntegrityCheck op de combinaties is er niet.
OntkoppelStedelijkeKlasses hoort niet bij deze reeks. Het is een debugschakelaar waarmee alleen de landbouw alloceert en de stedelijke sectoren hun ingangsstand overnemen; in een volle reeks staat hij op FALSE.